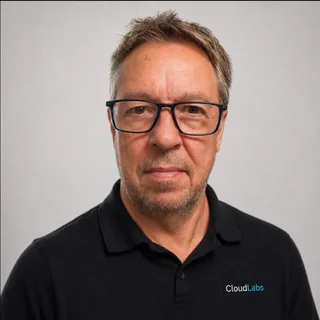
Server & Cluster Specialist
Hans Vredevoort
40+ jaar Microsoft-infrastructuur, meer dan tien jaar Microsoft MVP en een lange staat van dienst in Failover Clustering en Hyper-V.
LinkedIn-profiel →Windows Failover Cluster engineering
ClusterTriage zet actuele configuratie om in verdedigbare bevindingen, prioriteiten en aantoonbare verbetering. We richten ons op de clusterketen waar kleine inconsistenties grote operationele risico's kunnen worden.
Meten · Analyseren · Prioriteren · Remediëren · Verifiëren · Herhalen
Actieve storing? Bekijk alvast de aparte ClusterDown-incidentroute →De jaarcyclus laat zien of remediatie de gemeten toestand werkelijk heeft veranderd.
Drie duidelijke ingangen
Eén specialistisch domein, maar drie verschillende klantvragen.
Een jaarprogramma met basismeting, verificatie van herstel en zicht op configuratiedrift over vier metingen.
Bekijk Assurance →02 · METHODEBekijk de echte toolchain van intake en collectors via grading en bevindingen naar rapporten en de terugkoppeling naar remediatie.
Open Methode →03 · INCIDENTDe aparte route voor een cluster dat nu down of instabiel is. Eerst bewijs veiligstellen, daarna bepalen hoe diep het onderzoek moet gaan.
Bekijk ClusterDown-preview →Geen black box
De Methode-pagina gebruikt de echte ClusterTriage-toolchain. U ziet wat het proces ingaat, welke modules wat meten, hoe meetwaarden bevindingen worden en welke documenten eruit komen.
De vergrootglazen openen de onderliggende modules, catalogus, registers en rapporten.
Over ons
40+ jaar Microsoft-infrastructuur, meer dan tien jaar Microsoft MVP en een lange staat van dienst in Failover Clustering en Hyper-V.
LinkedIn-profiel →
Performance, observability en Windows-internals, met een lange technische achtergrond in Microsoft-platformen en enterprise-infrastructuur.
LinkedIn-profiel →